
Eine Webanwendung würde kaum ohne Authentifizierung, Eingabevalidierung und Rate Limits veröffentlicht. Viele Teams veröffentlichen KI-Agenten dennoch ohne vergleichbare Schutzmaßnahmen. Der Agent funktioniert in der Demo und gelangt in den Produktivbetrieb. Erst bei den ersten Angriffsversuchen zeigt sich unvorhergesehenes Verhalten.
Die Checkliste erläutert, mit welchen Schutzmaßnahmen KI-Agenten vor dem Go-live abgesichert werden und wie sie umgesetzt werden.
Das Bedrohungsmodell für KI-Agenten
Die Sicherheitsrisiken von KI-Agenten sind nicht theoretisch. Die OWASP Top 10 for Agentic Applications 2026 erweitern das Bedrohungsmodell über den KI-Modell-Output hinaus um Goal Hijacking, Tool Misuse, Privilege Abuse, Memory und Context Poisoning sowie Cascading Failures. Diese Risiken wachsen, wenn ein Agent mit der Identität eines Nutzers oder persistentem Kontext systemübergreifend handeln kann.
Die Absicherung eines Agenten beginnt mit dem Verständnis der relevanten Bedrohungen. Diese Angriffe treten im Produktivbetrieb auf:
ENISA-Update zur Bedrohungslage 2026
Der am 22. September 2026 veröffentlichte ENISA Threat Landscape 2026 untersucht Vorfälle und Ereignisse, die vom 1. Januar bis zum 31. Dezember 2025 beobachtet wurden.
Laut ENISAs Zusammenfassung waren 73 % der angegriffenen Organisationen als wesentliche oder wichtige Einrichtungen nach NIS2 eingestuft. Die Sektoranalyse im Bericht bezieht diesen Anteil auf erfasste Ereignisse. Die Angabe beschreibt den Vorfalldatensatz für 2025. Sie sagt weder aus, welcher Anteil aller NIS2-Einrichtungen angegriffen wurde, noch welcher Anteil der Angriffe KI einbezog.
Der Bericht beschreibt, wie Angreifer 2025 KI zur Erweiterung ihrer bestehenden Fähigkeiten einsetzten. Für die Zukunft erwartet ENISA, dass neue KI-Modelle zunehmend für schädliche Operationen genutzt werden. Der Ausblick auf KI prognostiziert mehr Automatisierung sowie schnellere und umfangreichere Operationen. Betreiber in kritischen Sektoren können sich vorbereiten, indem sie Agentenzugriffe begrenzen, folgenreiche Aktionen an Freigaben binden und die Eindämmung kompromittierter Workflows üben.
Sichere Agenten für den Produktivbetrieb ab
Isolation, Secret-Verwaltung, Guardrails und Audit-Logging sind in die Plattform integriert.
Sicherheitscheckliste für den Produktivbetrieb
Diese Schutzmaßnahmen sollten eingerichtet sein, bevor ein Agent echten Nutzern gegenübersteht. Zu jeder Schutzmaßnahme folgt eine konkrete Implementierungsanleitung.
1. Prompt Injection im Input blockieren
Jede Nutzernachricht sollte auf Injection-Versuche geprüft werden, bevor der Agent sie verarbeitet.
Wirksame Prompt-Injection-Erkennung geht über Keyword-Matching hinaus. Sie muss Folgendes erkennen:
- →Direktes Überschreiben von Anweisungen: „Ignoriere vorherige Anweisungen“ und Varianten
- →Encoding-Angriffe: Base64-codierte Anweisungen, hexadezimal codierte Payloads
- →Zeichenmanipulation: Typoglykämie (vertauschte Zeichen), Unicode-Substitution
- →Strukturelle Angriffe: Delimiter-Injection, Kontextmanipulation durch Formatierung
guardrails:
  input:
    - type: prompt_injection
      mode: block
      config:
        sensitivity: medium  # low, medium, or high
Wird eine Prompt Injection erkannt, wird der Agent nicht ausgeführt. Die Anwendung gibt eine Ablehnung aus und erfasst den Versuch zur Sicherheitsprüfung als Trace-Span.
provider in der Guardrail-Konfiguration.2. Personenbezogene Daten schützen, bevor sie das KI-Modell erreichen
In Nutzereingaben können sensible Daten enthalten sein. Entscheidend ist, ob diese Daten die API des KI-Modell-Providers erreichen oder zuvor abgefangen werden.
Drei Modi stehen zur Verfügung:
[EMAIL_REDACTED]. Der Agent verarbeitet den bereinigten Input. Dieser Modus bietet einen Kompromiss zwischen Schutz und Nutzbarkeit.guardrails:
input:
- type: pii
mode: redact
config:
entities: [email, phone, ssn, credit_card, api_key]
output:
- type: pii_leakage
mode: redactAuch der Output-Guardrail ist wichtig. PII kann in Antworten des Agenten erscheinen, selbst wenn sie nicht im ursprünglichen Input enthalten war. Wenn ein Agent über Tools oder Retrieval auf Kundendaten zugreift, verhindert die PII-Erkennung im Output, dass sensible Informationen in Antworten sichtbar werden.
3. Offenlegung des System-Prompts verhindern
Ein System-Prompt enthält die Persönlichkeit des Agenten, Geschäftsregeln, Tool-Schemas und Betriebsanweisungen. Extrahiert ein Angreifer ihn, besitzt er einen Bauplan zur Manipulation des Agenten.
guardrails:
  output:
    - type: system_prompt_leakage
      mode: block
Jede Antwort des Agenten wird auf Fragmente geprüft, die dem System-Prompt entsprechen. Beginnt der Agent seine Anweisungen offenzulegen, wird die Antwort blockiert und durch eine sichere Nachricht ersetzt.
4. Den Agenten auf seinen Aufgabenbereich begrenzen
Sprachmodelle beantworten bereitwillig Fragen zu jedem Thema. Ein Support-Agent für Abrechnungsfragen sollte weder Kochtipps noch medizinische Empfehlungen geben. Topic Restriction hält den Agenten auf seine vorgesehene Aufgabe fokussiert.
guardrails:
  input:
    - type: topic_restriction
      mode: block
      config:
        allowed_topics:
          - billing and payments
          - subscription management
          - account settings
        off_topic_message: "I can only help with billing and account questions."
        model: connic/gpt-5.6-luna
Je nach Einsatzbereich lassen sich erlaubte oder blockierte Themen definieren. Die Prüfung nutzt einen schlanken LLM-Call zur Klassifizierung und benötigt daher einen KI-Modellparameter. Ein schnelles, günstiges KI-Modell hält Latenz und Kosten niedrig.
5. Output-Inhalte moderieren
Auch mit einem guten System-Prompt können Sprachmodelle unangemessene Inhalte erzeugen. Inhaltsmoderation im Output erkennt Toxizität, Belästigung, Hassrede und andere Verstöße gegen Richtlinien vor der Ausgabe.
guardrails:
  output:
    - type: moderation
      mode: block
      config:
        categories:
          - hate
          - harassment
          - violence
          - self_harm
6. Versuche zum Datenabfluss erkennen
Ein subtiler, aber gefährlicher Angriff: Prompts veranlassen den Agenten, sensible Daten in URLs, Markdown-Bildern oder strukturierten Ausgaben zu codieren und an externe Server zu senden. Besonders gefährlich ist dies für Agenten mit Tool-basiertem Zugriff auf interne Daten.
guardrails:
  output:
    - type: data_exfiltration
      mode: block
      config:
        allowed_domains:
          - yourdomain.com
          - docs.yourdomain.com
Dies erkennt verdächtige URLs mit codierten Daten in Query-Parametern, auf externe Domains verweisende Markdown-Bild-Tags und Base64-codierte Datenblöcke in der Antwort. Die Liste erlaubter Domains stellt sicher, dass legitime Referenzen nicht blockiert werden.
7. Eigene Geschäftsregeln ergänzen
Jedes Unternehmen hat eigene Sicherheitsanforderungen, die integrierte Guardrails nicht vollständig abdecken können. Eigene Guardrails unterstützen beliebige Validierungslogik in Python.
from connic import GuardrailResult

REQUIRED_DISCLAIMERS = [
    "not financial advice",
    "consult a professional",
]

def check(content: str, context: dict) -> GuardrailResult:
    """Ensure financial responses include disclaimers."""
    agent_name = context.get("agent_name", "")
    if "finance" not in agent_name:
        return GuardrailResult(passed=True)

    content_lower = content.lower()
    has_disclaimer = any(d in content_lower for d in REQUIRED_DISCLAIMERS)

    if not has_disclaimer:
        return GuardrailResult(
            passed=False,
            message="Response must include a disclaimer.",
        )
    return GuardrailResult(passed=True)
Gängige eigene Guardrails blockieren Erwähnungen von Wettbewerbern, prüfen regulatorische Compliance-Hinweise, filtern interne Terminologie oder wenden domänenspezifische Validierungsregeln an.
8. Output-Relevanz prüfen
Manchmal liefert ein Agent zwar keine schädlichen Inhalte, beantwortet aber die eigentliche Frage nicht. Die Relevanzprüfung erkennt Goal Hijacking, bei dem ein Angreifer den Zweck des Agenten subtil umlenkt, sowie erfundene Inhalte abseits der eigentlichen Frage.
guardrails:
  output:
    - type: relevance
      mode: warn
      config:
        model: connic/gpt-5.6-luna
Der Warn-Modus zeigt zunächst die Häufigkeit irrelevanter Antworten. Ist die Rate inakzeptabel, folgt der Wechsel in den Block-Modus.
9. Tool-Rechte begrenzen und folgenreiche Aktionen freigeben lassen
Nur die Tools bereitstellen, die ein Workflow benötigt. Integrierte Datenbank-Tools auf erlaubte Collections sowie Lese- und Schreiboperationen beschränken und Retrieval-Tools auf die benötigten Namespaces begrenzen. Ein erlaubter Retrieval-Namespace gewährt auch Zugriff auf seine untergeordneten Namespaces. Eigene Tools benötigen eigene Berechtigungsprüfungen und eng begrenzte Zugangsdaten für externe Systeme. Produktiv- und Testzugangsdaten über umgebungsgebundene Variablen getrennt halten.
Für Löschvorgänge, Zahlungen oder Änderungen an Zugriffsrechten Freigaben konfigurieren. Nur konfigurierte Tools warten auf eine Freigabe; andere Tools werden regulär ausgeführt. Das vorgeschlagene Tool und seine Parameter prüfen und Entscheidungen auf benannte Mitglieder mit der Berechtigung approvals.decide beschränken. Bei on_rejection: fail scheitert der Run nach Ablehnung oder Timeout. Bei on_rejection: continue wird das abgelehnte Tool übersprungen, der Agent kann aber eine andere Aktion verfolgen. Dieses Verhalten anhand der erlaubten Alternativen des Workflows testen.
Alles zusammenführen
Eine vollständige Guardrail-Konfiguration für einen Support-Agenten im Produktivbetrieb:
version: "1.0"
name: customer-support
model: connic/gpt-5.6-terra
system_prompt: |
  You are a customer support agent for Acme Corp.
  Help customers with orders, billing, and product questions.
tools:
  - support.search_orders
  - support.search_retrieval
  - support.create_ticket

guardrails:
  input:
    - type: prompt_injection
      mode: block
      config:
        sensitivity: medium
    - type: pii
      mode: redact
      config:
        entities: [email, phone, ssn, credit_card]
    - type: topic_restriction
      mode: block
      config:
        allowed_topics: [orders, billing, products, returns]
        off_topic_message: "I can only help with Acme Corp products and orders."
        model: connic/gpt-5.6-luna
  output:
    - type: moderation
      mode: block
    - type: system_prompt_leakage
      mode: block
    - type: pii_leakage
      mode: redact
    - type: data_exfiltration
      mode: block
      config:
        allowed_domains: [acmecorp.com]
    - type: relevance
      mode: warn
      config:
model: connic/gpt-5.6-lunaObservability: sehen, was erkannt wird
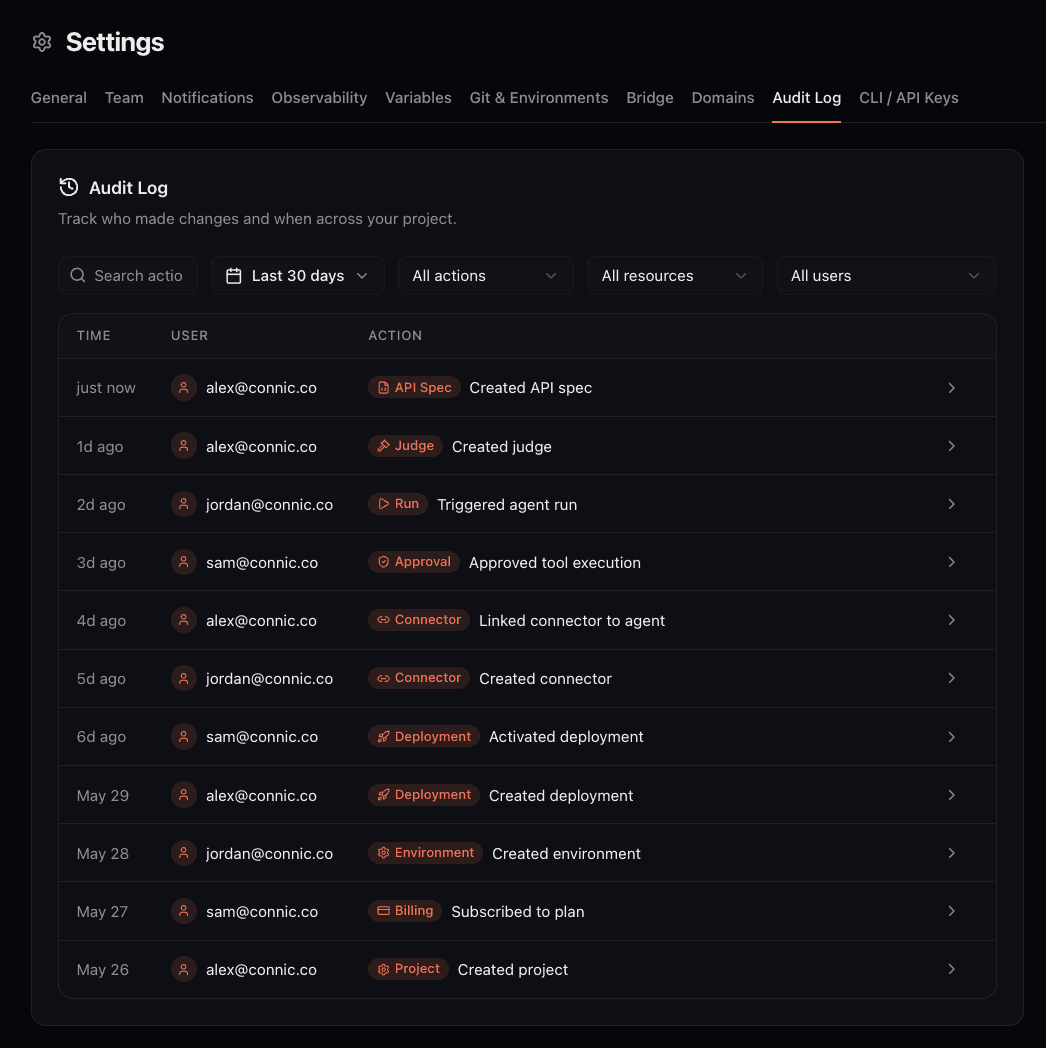
Run-Traces zeigen Guardrail-Prüfungen zusammen mit Tool-Calls und Fehlern. Das separate Projekt-Audit-Log erfasst Teamaktionen, darunter Freigabeentscheidungen. Für die Untersuchung eines Vorfalls werden sowohl die Ausführungsdaten als auch die Entscheidungen benötigt, die eine Aktion ermöglicht haben.
Die Dokumentation zu Logging und Debugging erklärt die Untersuchung von Traces und Logs aus eigenem Code. Pro Run werden höchstens 500 Logzeilen aus eigenem Code erfasst; weitere Zeilen werden verworfen. Die Aufbewahrungsdauer für Runs festlegen und Belege für Vorfälle sichern, bevor Runs gelöscht werden. Die Schwärzungsregeln einer Umgebung erfassen ausgewählte JSON-Felder in neuen Aufzeichnungen. Secrets in reinem Text und bestehende Aufzeichnungen bleiben unverändert. Zugangsdaten deshalb nicht in Logs schreiben.
Mit diesen Daten lassen sich Fragen beantworten wie: Wie häufig wird Prompt Injection versucht? Welche Agenten lösen die meisten PII-Schwärzungen aus? Sind Themenbeschränkungen zu aggressiv? Guardrails lassen sich so anhand realer Traffic-Muster abstimmen.
Mehrschichtige Absicherung über Guardrails hinaus
Guardrails bilden die Sicherheitsschicht der Runtime. Eine vollständige Sicherheitsstrategie umfasst jedoch weitere Schutzmaßnahmen:
Checkliste für kritische Sektoren vor dem Start und bei Vorfällen
Bei Workflows für wesentliche Dienste sollte die Prüfung vor dem Produktivstart ein erprobtes Verfahren zur Eindämmung von Vorfällen und Wiederherstellung umfassen. Diese Betriebsprüfungen ergänzen die Guardrail-Konfiguration oben; sie belegen keine NIS2-Konformität.
Vor dem Produktivstart
- Erreichbare Systeme, erlaubte Daten, Tool-Operationen und Zugangsdaten erfassen. Prüfen, dass Zugriffe auf fremde Collections, Namespaces und Umgebungen abgewiesen werden, auch über eigene Tools.
- Jeden folgenreichen Tool-Call mit Freigabe, Ablehnung und Timeout testen. Sicherstellen, dass Prüfende genug Kontext sehen und kein alternatives Tool die vorgesehene Freigabe umgeht.
- Eine Testaktion von der Eingabe über Tool-Parameter und Freigabe bis zum Ergebnis im externen System nachvollziehen. Logzugriff, JSON-Schwärzung, Aufbewahrung und die Sicherung von Vorfallsaufzeichnungen prüfen.
- Eine für Vorfälle verantwortliche Person benennen und das Stoppen neuer Anfragen, den Abbruch laufender Arbeit, den Widerruf von Zugangsdaten und die Wiederherstellung eines nachweislich funktionierenden Deployments üben. Für den Ausfall des Agenten einen manuellen Betriebsablauf bereithalten.
Bei Verdacht auf einen Vorfall
- Neue Anfragen an ihren Quellen stoppen und betroffene Verbindungen pausieren. Geplante, wartende oder laufende Ausführungen über die Run-Verwaltung abbrechen. Der Abbruch wirkt nicht sofort und kann bereits abgeschlossene externe Aktionen nicht rückgängig machen.
- Betroffene Zugangsdaten beim externen Anbieter widerrufen, bevor ausstehende Freigaben entschieden werden. Eine Ablehnung mit
on_rejection: continuekann den Run fortsetzen. Der Zugriff auf betroffene Systeme muss deshalb während der Untersuchung entzogen bleiben. - Run-IDs, Traces, Freigabeentscheidungen, Projekt-Audit-Logs und Aufzeichnungen externer Systeme sichern. Betroffene Daten und Aktionen dokumentieren und die Verantwortlichen für Incident Response und Compliance zur Prüfung von Meldepflichten einbeziehen.
- Die fehlerhafte Zugriffsregel, Freigabekonfiguration oder Tool-Funktion korrigieren. Den Vorfall in einer isolierten Testumgebung sicher reproduzieren und die Korrektur prüfen. Umgebungsvariablen aktualisieren und vor der Wiederaufnahme ein neues Deployment erstellen; eine Variablenänderung aktualisiert kein bestehendes Deployment.
Erste Schritte
Für eine neue Implementierung empfiehlt sich dieser Ansatz:
Mit der Grundkonfiguration starten.
prompt_injectionundpiiim Input sowiemoderationundsystem_prompt_leakageim Output decken die häufigsten Angriffsvektoren ab.In einer Testumgebung abstimmen. Die Erkennung im Warn-Modus mit nicht sensiblen Testeingaben prüfen. Bevor Produktivdaten oder folgenreiche Tools zugänglich sind, müssen die erforderlichen Blockier- und Schwärzungskontrollen aktiv sein.
Anhand des Traffics erweitern. Sobald reale Nutzungsmuster sichtbar sind, folgen Topic Restriction, Relevance Checking und eigene Guardrails auf Basis der tatsächlich beobachteten Risiken.
Trace-Daten regelmäßig prüfen. Häufig ausgelöste Guardrails und ihre Muster sollten untersucht werden. Empfindlichkeit und Modi lassen sich anpassen, sobald der Traffic besser verstanden ist.
Die vollständige Konfigurationsreferenz steht in der Guardrails-Dokumentation. Einen tieferen Einblick in die integrierten Guardrail-Typen bietet Guardrails für KI-Agenten: Sicherheit in Echtzeit.