
Beim automatisierten Agenten-Scoring bewertet ein LLM jeden Agenten-Run nach festgelegten Kriterien, statt dass jemand die Antworten manuell liest. Sobald KI-Agenten echten Traffic verarbeiten, führen fehlende Messwerte zu Änderungen nach Gefühl statt anhand von Daten.
Manuelle Reviews skalieren nicht auf Hunderte oder Tausende Runs pro Tag. Automatisierte Evaluation nutzt ein LLM, das Agenten-Runs nach festgelegten Kriterien bewertet, Qualitätstrends sichtbar macht und das Team bei Verschlechterungen alarmiert.
Dieses Muster heißt LLM as a Judge. Bei connic heißen die Bewertungen Judges. Damit lässt sich die Qualität eines Agenten messen und im Zeitverlauf verfolgen.
Warum automatisierte Evaluation wichtig ist
KI-Agenten sind nicht deterministisch. Derselbe Input kann in verschiedenen Runs zu unterschiedlichen Outputs führen. Eine Prompt-Änderung kann einen Anwendungsfall verbessern und einen anderen verschlechtern. Ohne kontinuierliche Evaluation fallen Qualitätsprobleme erst auf, wenn Beschwerden eingehen.
Bewerte jeden Agenten-Run automatisch
LLM-as-Judge-Evaluation bewertet Ausgaben von Agenten nach festgelegten Kriterien. Ein separates Evaluationstool ist nicht erforderlich.
Weiterführende Quellen: Judges.
So funktionieren LLM Judges
Das Prinzip ist einfach: Ein Sprachmodell bewertet den Output eines anderen. Ein Bewertungsschema definiert die konkreten Kriterien für den Anwendungsfall. Das Judge-LLM bewertet Agenten-Runs nach diesem Schema. Studien aus dem Jahr 2025 ergänzen frühere Ergebnisse zu LLM as a Judge um wichtige Nuancen. Huang et al. (2025) stellten fest, dass feinabgestimmte Judges innerhalb ihrer Domäne gut funktionieren können, aber bei Generalisierbarkeit, Fairness und Anpassungsfähigkeit nachlassen. Dagegen zeigten Thakur et al. (2025), dass hohe Übereinstimmung relevante Score-Unterschiede und Prompt-Sensitivität verbergen kann. Die praktische Antwort lautet Kalibrierung. Wir bieten Bewertungsschemata, Filter, Stichprobenraten, gespeichertes Reasoning, einen Score-Verlauf und Warnmeldungen, um diesen Evaluationszyklus kontinuierlich zu betreiben.
Der Judge erhält den vollständigen Ausführungskontext: Input, Output, Ausführungs-Traces, Token-Nutzung und Kontext-Metadaten. Er bewertet jedes Kriterium einzeln und liefert jeweils einen Score mit Begründung.
Einen Judge einrichten
Ein Judge hat vier Bestandteile: den bewerteten Agenten, das KI-Modell für das Scoring, die Bewertungskriterien und die Auslösekonfiguration.
Scoring-Kriterien definieren
Das ist der wichtigste Schritt. Vage Kriterien erzeugen inkonsistente Scores. Konkrete Kriterien führen zu nützlichen, verwertbaren Evaluationen.
Vage Kriterien- • „Qualität“ (max. 10)
- • „Hilfreich“ (max. 10)
- • „Gute Antwort“ (max. 10)
Konkrete Kriterien- • „Alle Rechnungspositionen extrahiert“ (max. 10)
- • „Richtiges Tool für die Aufgabe verwendet“ (max. 5)
- • „Antwort unter 200 Wörtern“ (max. 5)
Jedes Kriterium erhält einen Namen, eine Beschreibung dessen, was der Judge genau bewerten soll, und einen maximalen Score. Der Judge bewertet alle unabhängig voneinander. So wird sichtbar, welche Leistungsaspekte stark sind und welche verbessert werden müssen.
Einen Auslösemodus auswählen
AutomaticEvaluiert Ausführungen nach ihrem Abschluss. Eine Stichprobenrate zwischen 1 und 100 % bringt Abdeckung und Kosten ins Gleichgewicht; Filter begrenzen die Evaluation auf den relevanten Traffic.ManualDie Evaluation wird für bestimmte Runs ausdrücklich gestartet. Das eignet sich zum Testen einer neuen Judge-Konfiguration, zur erneuten Evaluation nach geänderten Kriterien oder zur Stichprobe verdächtiger Runs.Tipp: erst kalibrieren, dann automatisierenIm manuellen Modus lässt sich zunächst eine repräsentative Auswahl von Runs mit den Erwartungen des Teams vergleichen. Nach der Kalibrierung des Bewertungsrasters kann für kontinuierliches Monitoring in den automatischen Modus gewechselt werden.Optional einen System-Prompt ergänzen
Der Judge benötigt Informationen zum Fachgebiet. Wenn ein Agent Erstattungsansprüche gegenüber einer Krankenversicherung bearbeitet, sollte beschrieben sein, wie eine korrekte Entscheidung aussieht. Schreibt ein Agent Marketingtexte, gehören Markenstil und Qualitätsanspruch in den Kontext.
Example Judge System PromptYou are evaluating a customer support agent for an e-commerce platform. A high-quality response should: - Directly address the customer's specific question - Reference the correct order, product, or policy - Provide actionable next steps (not generic advice) - Maintain a professional, empathetic tone - Avoid making promises the company cannot keep If the agent used tools, verify it queried the correct data before responding.Auch der System-Prompt des bewerteten Agenten kann in den Kontext des Judges aufgenommen werden. Damit kennt er sowohl die vorgesehene Aufgabe als auch das tatsächliche Verhalten des Agenten.
Ein vollständiges Beispiel
Ein praktisches Beispiel: die Evaluation eines Agenten, der Daten aus Rechnungen extrahiert.
KI-Modell
openai/gpt-5.4 (oder ein anderes KI-Modell mit starkem Reasoning)
Trigger
Automatic: 100 % Sample Rate (geringes Volumen, jede Ausführung wird evaluiert)
Kriterien
Mit diesem Setup erhält jeder Run zur Rechnungsextraktion maximal 30 Punkte. Das Dashboard zeigt sofort, ob die Genauigkeit hoch ist, aber die Vollständigkeit sinkt, oder ob der Agent rät, statt Unsicherheiten zu markieren. Jeder Score enthält die Begründung des Judges.
Run Filter: Evaluation auf relevante Fälle konzentrieren
Nicht jeder Run braucht eine Evaluation. Filter wählen den gewünschten Traffic aus:
Damit lassen sich getrennte Judges für unterschiedliche Szenarien erstellen. Ein Support-Agent, der Fragen zur Abrechnung und Technik beantwortet, braucht möglicherweise zwei Judges mit eigenen Kriterien und Filtern statt einer vermischten Evaluation.
Warnungen bei Qualitätsverlust
Scores zeigen die Qualität. Warnungen machen das Team auf Probleme aufmerksam. Ein Score-Schwellenwert sorgt dafür, dass ein Unterschreiten eine Benachrichtigung auslöst.
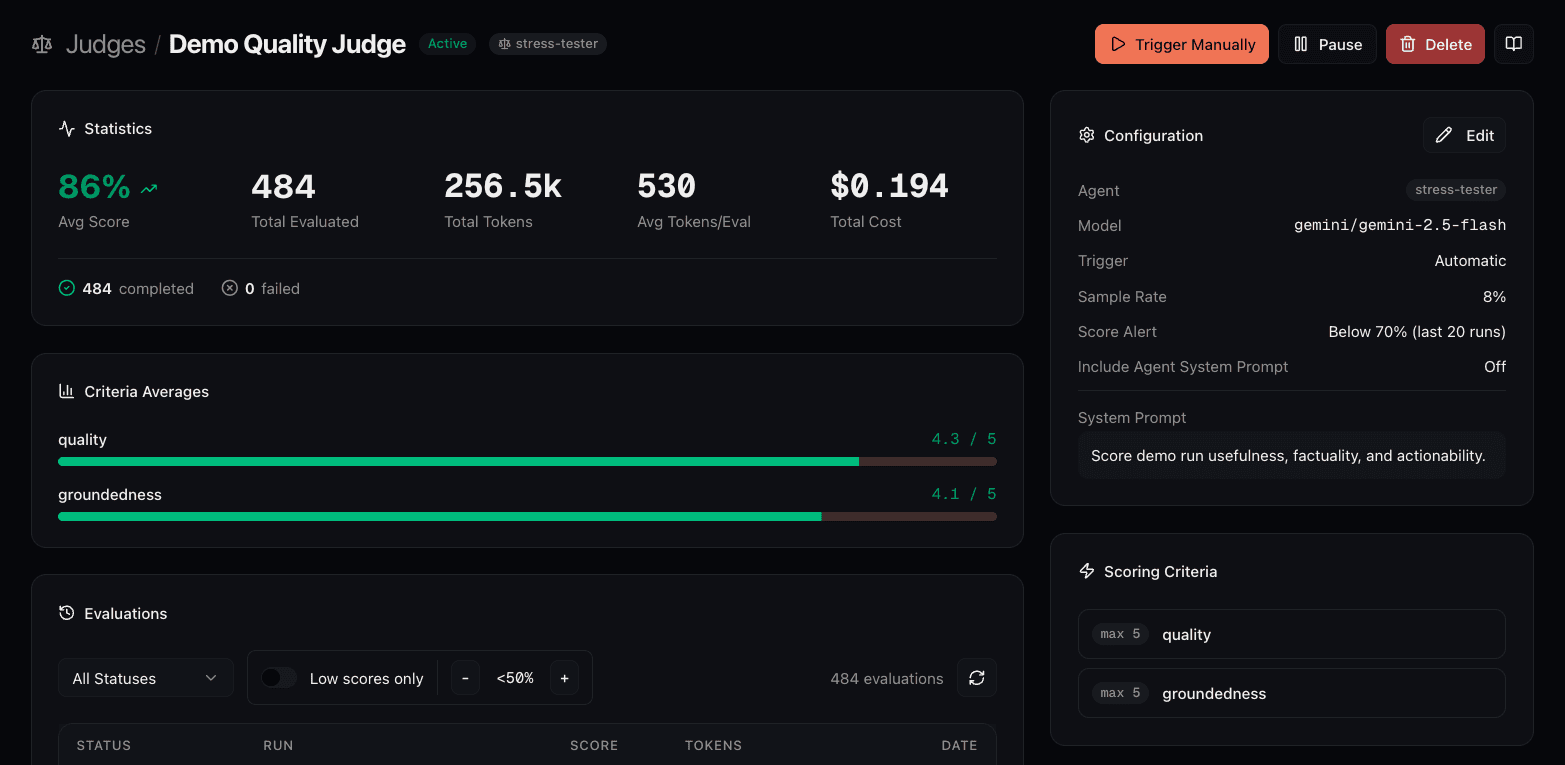
Was das Dashboard zeigt
Die Detailseite des Judges bietet eine umfassende Ansicht der Qualität im Zeitverlauf:
Praktische Muster
Diese Evaluationskonfigurationen eignen sich für den Produktivbetrieb:
Kosten berücksichtigen
Jede erfolgreich abgeschlossene Judge-Evaluation verbraucht eine zusätzliche Run-Einheit und führt einen LLM-Aufruf aus. Der Mengenrabatt des Run-Pakets gilt für die Judge-Run-Einheit, nicht für den Modellaufruf. So bleiben die Kosten im Rahmen:
- •Stichprobenraten für Agenten mit hohem Volumen nutzen. Eine passende Rate deckt den Traffic sinnvoll ab, ohne jeden Run zu evaluieren.
- •Effiziente Judge-KI-Modelle benchmarken. Ein günstigerer Judge kann Kosten senken; vor dem Wechsel sollte er mit demselben annotierten Datensatz validiert werden.
- •Kriterien fokussiert halten. Fünf konkrete Kriterien sind besser als zwanzig vage. Weniger Kriterien bedeuten auch kürzere Prompts und weniger Tokens.
- •Rauschen mit Filtern ausschließen. Testausführungen, internes Debugging und Traffic mit geringem Wert bleiben außerhalb der Evaluation.
Erste Schritte
Einen Judge zu einem bestehenden Agenten hinzuzufügen ist unkompliziert:
Im Projekt Judges öffnen und einen neuen Judge erstellen
Den zu evaluierenden Agenten und ein KI-Modell für den Judge auswählen
Drei bis fünf konkrete Bewertungskriterien mit eindeutigen Beschreibungen definieren
Im manuellen Modus mit einer Auswahl kürzlich geprüfter Ausführungen testen
Das Bewertungsraster verfeinern und anschließend zum automatischen Monitoring wechseln
Einen Score-Schwellenwert festlegen, damit Qualitätsverluste eine Warnung auslösen
Der schwierigste Teil sind gute Beschreibungen der Kriterien, die besondere Aufmerksamkeit verdienen. Alles andere ist Konfiguration.
Der vollständige Einrichtungsleitfaden steht in der Judges-Dokumentation. Für den Einstieg in connic zeigt der Quickstart-Leitfaden das Deployment eines ersten Agenten und die anschließende Ergänzung um einen Judge zur Qualitätsmessung.