Zum Hauptinhalt springen
connic

RAG-Tutorial für KI-Agenten: Retrieval mit Quellenangaben

Ein RAG-Agent für den Produktivbetrieb braucht abgegrenzte Retrieval-Namespaces, Read-only-Berechtigungen, Quellenangaben, eigene Tool-Wrapper und Regressionstests.

15. November 2025(zuletzt aktualisiert: 17. August 2026)9 Min. LesezeitAutor: connic engineering

RAG im Produktivbetrieb gibt einem KI-Agenten eine eng begrenzte Suchfunktion. Bei connic liegen vertrauenswürdige Inhalte in einem benannten Namespace; ein zweckgebundenes Python-Tool kapselt die semantische Suche. Die Agentenkonfiguration in YAML erzwingt Lesezugriff und Tests prüfen Tool-Auswahl sowie Quellenangaben vor dem Deployment.

Früher Knowledge Base

Welche Regeln für Retrieval im Produktivbetrieb gelten

Retrieval-augmented Generation ergänzt einen Agenten-Run um relevante Passagen, bevor das KI-Modell antwortet. Die semantische Suche findet Passagen nach ihrer Bedeutung. Sie entscheidet jedoch nicht, welche Inhalte freigegeben sind, ob der Agent hineinschreiben darf oder wie die Antwort ihre Belege zitiert. Diese Entscheidungen gehören in die Konfiguration von Tool und Agenten.

Fest definierter Suchbereich
Das eigene Tool legt Namespace, Score-Schwellenwert und Ergebnislimit fest. Die Auswahl der durchsuchten Inhalte bleibt im Code; das KI-Modell liefert nur die Frage.
Zugriffskontrollen in der Runtime
Die Agentenkonfiguration in YAML setzt Namespaces auf eine Allowlist und kann Schreiben sowie Löschen blockieren. Dieselben Prüfungen greifen, wenn ein eigenes Tool eine vordefinierte Retrieval-Funktion aufruft.
Einheitliche Quellenangaben
Der Wrapper überführt Quellenfelder in eine stabile Struktur. Der System-Prompt legt fest, wann das KI-Modell diese Belege zitiert und wie es reagiert, wenn keine Passage eine Antwort stützt.
Tests für Suche und Quellenangaben
Tests prüfen, dass Richtlinienfragen das Such-Tool aufrufen, irrelevante Prompts nicht und fundierte Antworten die erwartete Quellenreferenz enthalten.

Entwickle Agenten mit verlässlichen Quellen

Lege den Suchbereich deines Agenten fest, nutze nach Namespace indexierte Inhalte und verfolge jeden Retrieval-Aufruf im Trace.

  1. Freigegebene Inhalte in einem Namespace indexieren

    Auf der Seite Retrieval lassen sich die Dokumente hochladen, die der Agent verwenden darf. Sie erhalten einen Namespace wie support.approved und eine aussagekräftige Eintrags-ID wie refund-policy-2026. Eine Abfrage gegen einen übergeordneten Namespace durchsucht auch dessen untergeordnete Namespaces. Eine stabile Hierarchie lässt daher Raum, Richtlinien, Produktdokumentation und Runbooks später zu trennen.
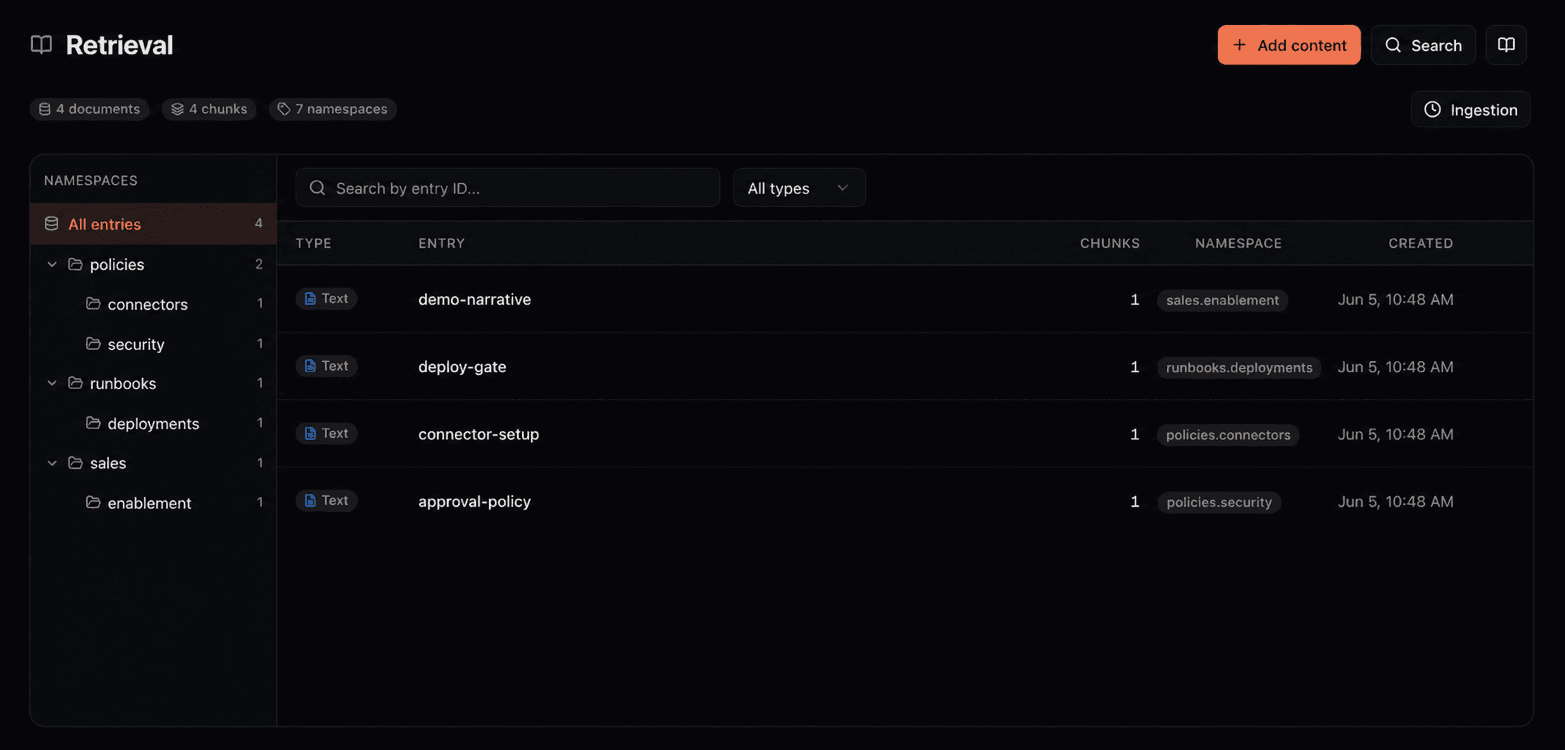
    connic retrieval mit Richtlinien- und Runbook-Dokumenten in einem Namespace-Baum sowie Angaben zu Chunk-Anzahl und Inhaltstyp
    Die Seite Retrieval gruppiert indexierte Einträge nach Namespace und zeigt die für die semantische Suche verfügbaren Inhalte.

    Uploads werden asynchron indexiert. Nach Abschluss des Indexierungsauftrags sollten repräsentative Fragen über die Abfrage im Dashboard geprüft werden, bevor der Index mit einem Agenten verbunden wird. Upload und Prüfung von Retrieval-Inhalten.

  2. Ein zweckgebundenes Such-Tool bereitstellen

    Eigene Tools sind normale typisierte Python-Funktionen unter tools/. Ein Decorator ist nicht erforderlich. connic erstellt aus Funktionssignatur und Docstring das Schema, das das KI-Modell sieht. Dieser Wrapper fixiert den Namespace und gibt nur die Passage und Quellenfelder zurück, die der Support-Agent benötigt:

    tools/support_knowledge.py
    from connic.tools import retrieval_query
    
    async def search_support_docs(question: str) -> list[dict]:
        """Find approved support passages for a customer question.
    
        Args:
            question: The customer's policy or product question.
        """
        result = await retrieval_query(
            query=question,
            namespace="support.approved",
            min_score=0.35,
            max_results=5,
        )
    
        matches = []
        for item in result.get("results", []):
            source = item["entry_id"]
            page = item.get("page_number")
            citation = f"{source}, p. {page}" if page else source
            matches.append({
                "passage": item["content"],
                "citation": citation,
            })
        return matches

    Die vordefinierte Funktion retrieval_query liefert nach Relevanz sortierte Chunks mit Quellenfeldern wie entry_id, namespace und, bei Quellen mit Seiten, page_number. Der Wrapper wandelt diese Felder in das Format für Quellenangaben um, das das Produkt darstellt. Unsere Plattform liefert die Belege; Tool und Prompt bestimmen, wie die Antwort sie zitiert.

    retrieval_query direkt anzuhängen, eignet sich für einen Prototyp oder einen vielseitig einsetzbaren internen Agenten. Ein produktiver Support-Agent sollte weder beliebige Namespaces wählen noch Suchparameter zur Laufzeit einstellen. Er sollte auch nicht retrieval_store erhalten, sofern das Schreiben indexierter Inhalte nicht zu seinen Aufgaben gehört. Für lesende Agenten bleibt die Indexierung im Dashboard, in einer Retrieval-Quelle oder in einer kontrollierten API-Pipeline. Referenz für Custom Retrieval Wrapper.

  3. Dieselbe Begrenzung im Agenten-YAML erzwingen

    Der Wrapper wird über Modul- und Funktionsnamen eingebunden. Der Retrieval-Block bildet eine zweite, durch die Runtime erzwungene Begrenzung: Dieser Agent erreicht nur support.approved und dessen untergeordnete Namespaces und kann dort keine Inhalte speichern oder löschen.

    agents/support-agent.yaml
    version: "1.0"
    
    name: support-agent
    type: llm
    model: connic/gpt-5.6-terra
    description: "Answers support questions from approved documentation"
    system_prompt: |
      Answer policy and product questions only from passages returned by
      search_support_docs. Cite every supported claim in square brackets
      using the citation value from the tool result.
    
      If the search returns no relevant passage, say that the approved
      documentation does not answer the question. Do not guess.
    
    tools:
      - support_knowledge.search_support_docs
    
    retrieval:
      namespaces:
        support.approved:
          prevent_write: true
          prevent_delete: true

    Der Wrapper verbessert die Tool-Schnittstelle; der Access-Block in YAML begrenzt die Möglichkeiten des zugrunde liegenden Retrieval-Aufrufs. Beides sollte erhalten bleiben. Ändert ein späteres Refactoring den Namespace im Wrapper, greift weiterhin die Allowlist auf Agent-Ebene, statt den Zugriff unbemerkt auszuweiten.

  4. Retrieval-Nutzung und Quellenangaben testen

    Für deterministische Agententests wird der eigene Wrapper gemockt. Der folgende Mock gibt eine bekannte Passage und Quellenangabe zurück, ohne vom aktuellen Inhalt des Index abhängig zu sein. Gemockte eigene Tool-Aufrufe erscheinen weiterhin im Trace und zählen für Tool-Call-Assertions.

    tests/mocks/support_knowledge.py
    def mock_support_knowledge_search_support_docs(tool_name, params, context):
        return [{
            "passage": "Enterprise refunds are available within 60 days.",
            "citation": "refund-policy-2026, p. 12",
        }]
    tests/support-agent.yaml
    version: "1.0"
    
    tests:
      - name: cites_the_refund_policy
        payload: "What is the enterprise refund window?"
        mocks: support_knowledge
        strict_mocks: true
        expected_tool_calls:
          - support_knowledge.search_support_docs: invocations == 1
        expected_result: '"[refund-policy-2026, p. 12]" in output'
    
      - name: skips_retrieval_for_a_greeting
        payload: "Say hello."
        mocks: support_knowledge
        strict_mocks: true
        expected_no_tool_calls:
          - support_knowledge.search_support_docs

    Der erste Fall erkennt Änderungen an KI-Modell oder Prompt, durch die keine Suche mehr stattfindet oder die Quellenreferenz entfällt. Der zweite erkennt unnötiges Retrieval bei einem Prompt, den das KI-Modell ohne Unternehmenswissen beantworten kann. Die Suite wird mit connic test ausgeführt; dieselben Tests laufen als Deployment-Prüfung. Ein zusätzlicher nicht gemockter Fall in einem Test-Environment erkennt auch Änderungen an Indexierung oder Relevanz. Referenz für Tool-Call-Assertions.

Prüfungen vor dem Produktivstart

Suchergebnisse vor der Anbindung an den Agenten prüfen
Echte Support-Fragen dienen als Abfragen für den Namespace. Dabei wird geprüft, ob die nützliche Passage den festgelegten Schwellenwert erreicht und ähnliche oder veraltete Dokumente die Ergebnisse nicht dominieren.
Lesende und schreibende Agenten trennen
Lesende Agenten erhalten zweckgebundene Abfrage-Wrapper und schreibgeschützte Namespaces. Muss ein Agent Inhalte hinzufügen, erhält er einen separaten Schreib-Wrapper und nur den Namespace, für den er verantwortlich ist.
Quellenangaben in der Antwort prüfen
Stabile Eintrags-IDs machen Quellenangaben überprüfbar. Tests sollten fehlschlagen, wenn eine fundierte Antwort ihre Quelle auslässt oder der Agent eine unternehmensspezifische Frage ohne Suche beantwortet.
Trace nach dem Deployment prüfen
Im Trace sollte erkennbar sein, dass der produktive Run den Wrapper einmal aufgerufen, die erwartete Frage verwendet und Belege geliefert hat, die die abschließende Antwort stützen.

Weitere Details enthalten die Referenz zu Retrieval-Abfragen und Speicherung und das Quickstart-Beispiel.

Häufig gestellte Fragen

Eine RAG-Konfiguration für den Produktivbetrieb legt den durchsuchbaren Namespace, Score-Schwellenwert und das Ergebnislimit in einem zweckgebundenen Tool fest. Der Agent erhält Lesezugriff auf freigegebene Inhalte und stabile Quellenfelder. Tests prüfen, wann Retrieval läuft und ob fundierte Antworten die erwartete Quelle nennen.

Direkter Zugriff auf retrieval_query ist für Prototypen und vielseitig einsetzbare interne Agenten nützlich. Für eine produktive Aufgabe wird die Funktion in einem typisierten Tool gekapselt. Dessen Eingabe ist die fachliche Frage, während der Code Namespace, Schwellenwert, Ergebnislimit und Antwortformat festlegt. Das KI-Modell sollte den Suchbereich nicht selbst zur Laufzeit festlegen.

Der Agent erhält einen zweckgebundenen Such-Wrapper; retrieval_store bleibt aus seiner Tool-Liste ausgeschlossen. prevent_write und prevent_delete beschränken den erlaubten Namespace in der Agentenkonfiguration in YAML. Uploads und die Synchronisierung von Quellen bleiben im Dashboard oder in einem separaten kontrollierten Importpfad.

Das zweckgebundene Such-Tool wird mit einer bekannten Passage und Quellenangabe gemockt. Ein Test prüft, dass eine Richtlinienfrage das Tool einmal aufruft und die abschließende Antwort die erwartete Quellenangabe enthält. Ein zweiter Fall erwartet bei irrelevanten Prompts keinen Retrieval-Aufruf; ein nicht gemockter Test in einem Test-Environment erkennt Änderungen an Relevanz und Indexierung.

Mehr aus dem Blog

Tutorial

KI-Token-Kosten nach Kunde oder Use Case in connic auswerten

Middleware versieht jeden Agenten-Run in connic mit Kunde oder Use Case, und Dashboards sowie die Seite Token Usage ordnen Token-Kosten nach diesem Wert.

15. Oktober 20267 Min. Lesezeit
Tutorial

Invoice Processor als MCP-Tool bereitstellen

connics Rechnungsvorlage als MCP-Tool bereitstellen, per Python aufrufen und die extrahierten Felder prüfen: vollständiges Client-Beispiel mit Testrechnung.

11. September 202610 Min. Lesezeit
Tutorial

KI-Agenten über Kafka-Topics auslösen

Eine eingehende connic-Kafka-Verbindung auf einem Topic startet mit jeder Nachricht einen Agenten-Run. Kafka-Verbindung konfigurieren, Agenten verknüpfen, bereitstellen und Runs beobachten.

12. Juli 20268 Min. Lesezeit
Tutorial

So integrieren kleine Engineering-Teams einen KI-Agenten in SaaS

Ein praktikabler Weg zum ersten KI-Agenten im Produktivbetrieb: Aufgabe eingrenzen, per Konfiguration definieren, vorhandene Systeme anbinden und die Runtime verwalten lassen.

12. Juni 20269 Min. Lesezeit
Tutorial

KI-Agenten automatisch mit LLM Judges bewerten

Ein LLM Judge bewertet ausgewählte oder alle passenden Agenten-Runs nach festgelegten Kriterien. Score-Trends und Alerts machen Regressionen sichtbar.

29. März 202610 Min. Lesezeit
Tutorial

Datenbank, Retrieval oder Sessions: Speicher für Agenten im Vergleich

connics Datenbank, Retrieval und persistente Sessions im Vergleich: passende Einsatzbereiche, gespeicherte Gesprächsverläufe, TTL und zugehörige Runs.

4. März 202612 Min. Lesezeit
Tutorial

KI-Agenten: Vom Prototyp zum Produktivbetrieb

Eine Demo funktioniert hervorragend, bis 1.000 Nutzer gleichzeitig darauf zugreifen. Dieser Leitfaden beschreibt die oft zu spät berücksichtigten Anforderungen des Produktivbetriebs.

10. Januar 202610 Min. Lesezeit
Tutorial

Versteckte Kosten beim Self-Hosting von KI-Agenten

Ein Kubernetes-Deployment wirkt zunächst einfach. Der Artikel vergleicht die tatsächlichen Kosten selbst gehosteter KI-Agenten mit einer verwalteten Plattform.

18. Dezember 20257 Min. Lesezeit
Tutorial

KI-Agenten ohne ML-Team in SaaS integrieren

Kunden erwarten KI-Features, auch wenn das Produktteam keine ML-Engineers beschäftigt. Vorhandene Fähigkeiten reichen aus, um KI-Agenten zu veröffentlichen.

5. Dezember 20258 Min. Lesezeit